
OT Bedrijfscontinuïteit en Herstelstrategie

Waarom 99% van de OT-back-ups faalt als de fabriek echt stilvalt (en hoe u uw bedrijf wél beschermt)

De recente, ontregelende cyberincidenten op kritieke nutsbedrijven en energie-infrastructuur in de Verenigde Staten en het Verenigd Koninkrijk hebben de kwetsbaarheid van onze fysieke wereld pijnlijk blootgelegd. In mijn dagelijkse praktijk met directies, risicomanagers en asset owners zie ik een harde realiteit: onze industriële infrastructuur en fysieke ketens draaien op Operationele Technologie (OT), maar de herstelbaarheid daarvan wordt ernstig onderschat.

Veel bestuurders gaan er vanuit dat stilstand voornamelijk het gevolg is van geavanceerde cyberaanvallen zoals ransomware. De werkelijkheid is echter veel genuanceerder: een fysieke installatie — of het nu gaat om een fabriek, waterzuivering of energie-installatie — hoeft niet eens gehackt te worden om stil te vallen. Een defecte controller, een beschadigde configuratie, een mislukte firmware-update of een menselijke fout van een medewerker die een verkeerde configuratie terugzet, heeft exact hetzelfde effect: de operatie stopt.

Hier wreekt zich het fundamentele verschil tussen kantoor-IT en OT. Bij traditionele IT draait een back-up om het veiligstellen en herstellen van data. Bij Operationele Technologie gaat het om een heel andere, existentiële vraag: kan de organisatie haar fysieke proces veilig en voorspelbaar opnieuw laten functioneren wanneer de digitale besturing uitvalt? Een effectieve OT-back-upstrategie begint daarom niet bij software of opslagcapaciteit, maar bij de bedrijfsimpact van fysieke stilstand.

Inzicht 1: De gevaarlijkste back-up is degene waarvan iedereen denkt dat hij werkt

Een groen vinkje op een IT-dashboard garandeert op geen enkele wijze dat uw fabriek na een calamiteit weer kan opstarten.

In veel organisaties kijkt de directie naar maandelijkse rapportages waarin staat dat "99,8% van de back-upjobs succesvol is afgerond". Dit geeft een gevaarlijke schijn van veiligheid. In een OT-omgeving gaat het namelijk om veel meer dan alleen het kopiëren van bestanden of data.

Wanneer men uitsluitend vanuit een IT-dataperspectief naar back-ups kijkt, ontbreken de meest cruciale elementen die nodig zijn om een fysieke installatie weer tot leven te wekken:

  • PLC- en DCS-besturingsprogramma's
  • HMI- en SCADA-configuraties en grafische bestanden
  • Engineeringprojecten en broncode
  • Netwerkconfiguraties en firewallregels
  • Specifieke firmware- en softwareversies
  • Procesparameters, recepturen en setpoints
  • Historische procesdata (Historian-databases)
  • Certificaten, licenties en gebruikersconfiguraties
  • Essentiële documentatie van kritieke assets

Om te voorkomen dat onopgemerkte of ongeautoriseerde wijzigingen in deze configuraties tot mislukte herstelacties leiden, maken geavanceerde OT-omgevingen gebruik van industriële DevOps (Git-gebaseerd versiebeheer) en geautomatiseerde wijzigingsdetectie. Dit legt exact vast wie welke PLC-logica of HMI-instelling heeft aangepast vóórdat er een back-up wordt gemaakt.

"De gevaarlijkste back-up is degene waarvan iedereen denkt dat hij werkt."

Analyse door Ricardo: De blinde vlek voor het management

Voor een manager is dit de grootste blinde vlek in bedrijfscontinuïteit. Een back-up kan technisch gezien 100% geslaagd zijn, maar operationeel waardeloos blijken als blijkt dat een specifieke licentie ontbreekt, de softwareversie niet meer wordt ondersteund, of de back-up niet overeenkomt met de fysieke status van de installatie.

Beoordeel uw OT-back-upomgeving daarom nooit op opgeslagen back-upvolume, maar uitsluitend op aantoonbare herstelbaarheid. De centrale vraag op directieniveau mag niet zijn of er een back-up is gemaakt, maar of een kritieke installatie met die back-up gecontroleerd en veilig hersteld kan worden.

Inzicht 2: OT is geen kantoor-IT – Waarom standaard back-ups falen in de fabriek

In kantoor-IT kunnen servers of laptops relatief eenvoudig worden vervangen of geüpdatet. In de OT-wereld is de digitale besturing direct verbonden met de fysieke werkelijkheid en afhankelijk van complexe randvoorwaarden.

Herstel in OT valt of staat met de levenscyclus van industriële assets en een duidelijke herstelprioritering. Niet elke asset heeft immers dezelfde urgentie. Zo kent een volwassen OT-herstelstrategie een gelaagde opbouw waarbij Tier 0 (Veiligheid & Kernbesturing) de absolute hoogste prioriteit krijgt. Safety Instrumented Systems (SIS) en kritieke veiligheids-PLC's moeten gegarandeerd en gecontroleerd functioneren voordat de reguliere procesbesturing of HMI-laag (Tier 1) weer online gebracht mag worden.

Veel installaties draaien bovendien op verouderde (legacy) apparatuur die specifieke beperkingen kent, zoals een gebrek aan moderne beveiligingsfuncties of beperkte beschikbaarheid van vervangende hardware. Een succesvolle herstelactie vereist daarom meer dan alleen een digitaal bestand; er is een fysieke keten van afhankelijkheden nodig:

  • Fysieke wisselstukken (spare parts plan): Hardware die 100% compatibel is met de digitale back-ups om vertragingen in de toeleveringsketen op te vangen.
  • Gespecialiseerde apparatuur: Beschikbaarheid van specifieke engineeringsoftware, licenties en gespecialiseerde kabels ter plaatse.
  • "Golden Image" strategie: Een schone, vooraf gevalideerde "Golden Image" van het Engineering Workstation (EWS) — inclusief besturingssysteem, programmeersoftware en bekende goedwerkende besturingslogica — bewaard op een offline drager om herbesmetting bij herstel te voorkomen.
  • Aanvullende fysieke en digitale documentatie: Documenten in zowel geprinte als elektronische vorm, waaronder I/O-lijsten, schakelschema's, netwerkdiagrammen, apparatuurspecificaties, Safety Requirements Specifications (SRS), control narratives en Cause & Effect-matrices.

Cybersecurity en IT kunnen de randvoorwaarden en infrastructuur leveren, maar Operations bepaalt uiteindelijk wat een veilige, werkbare en gecontroleerde herstelactie is.
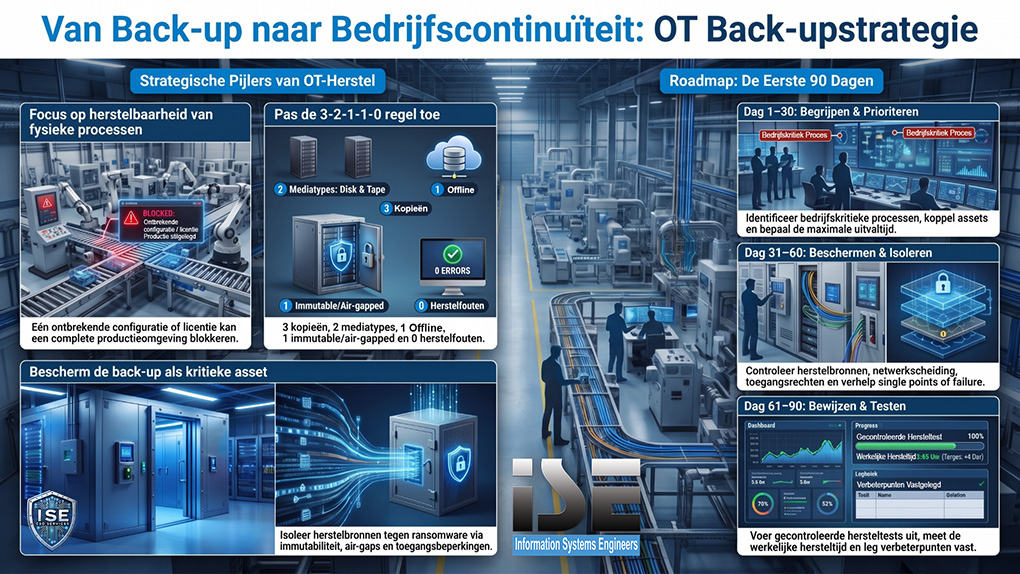
Info OT Back upstrategie

Inzicht 3: Bescherm de back-up alsof het uw meest kritieke asset is (De 3-2-1-1-0 Regel)

Bij moderne cyberincidenten (zoals ransomware-aanvallen) richt een aanvaller zich vaak niet direct op de productieomgeving. Het primaire doel is het uitschakelen of vernietigen van de back-ups en herstelmogelijkheden, zodat de organisatie geen uitweg meer heeft.

Een back-up die samen met de productieomgeving wordt vernietigd of versleuteld, biedt geen enkele continuïteit. Om dit te voorkomen, hanteren wij binnen OT de geavanceerde 3-2-1-1-0 Back-upregel:

  • 3 kopieën van de data en configuraties behouden.
  • 2 verschillende mediatypes gebruiken voor opslag.
  • 1 kopie op een offsite locatie bewaren.
  • 1 kopie bewaren die immutable (onveranderbaar/WORM-opslag) of air-gapped (fysiek losgekoppeld van het netwerk) is.
  • 0 fouten na automatische en periodieke herstelverificatie.


Analyse door Ricardo: De back-up als crisisinfrastructuur

De back-upomgeving is geen passief archief; het is een cruciaal onderdeel van uw crisisinfrastructuur. Dit betekent dat de back-upomgeving strikt gescheiden moet zijn van de productieomgeving. Zij mag niet afhankelijk zijn van dezelfde netwerkverbindingen, domeinen of gebruikersaccounts als het productienetwerk. Wie toegang heeft tot de productieomgeving, hoort niet automatisch autorisatie te hebben om back-ups te wijzigen of te verwijderen.

Inzicht 4: Testen zonder stilstand – Van aannames naar aantoonbare herstelbaarheid

Veel managers aarzelen om back-ups te testen uit angst voor productieverstoring of ongewenste stilstand. Dit leidt ertoe dat back-ups pas voor het eerst worden getest wanneer er een echt incident plaatsvindt — het slechtst denkbare moment.

Om te testen zonder risico voor de live productie, maken we gebruik van een Digital Twin (een virtuele sandbox-omgeving). Hierin kunnen herstelprocedures, patches en herstelketens veilig worden gevalideerd. Om stapsgewijs naar aantoonbare paraatheid toe te werken, hanteren we 5 herstelniveaus:

  1. Niveau 1: Bewijs van aanwezigheid — Kan het back-upbestand worden gevonden, geïndexeerd en geopend?
  2. Niveau 2: Technische restore — Kan het systeem of de configuratie succesvol worden teruggezet in een gecontroleerde testomgeving?
  3. Niveau 3: Functionele validatie — Gedraagt het herstelde systeem en de software zich inhoudelijk zoals verwacht?
  4. Niveau 4: Integrale hersteltest — Kunnen meerdere afhankelijke systemen (zoals PLC, HMI en SCADA) in samenhang worden hersteld?
  5. Niveau 5: Crisissimulatie — Kan het responsteam onder tijdsdruk en gesimuleerde crisissituaties de installatie herstellen?

Om te garanderen dat herstelde code en configuraties 100% zuiver zijn en niet zijn aangetast, maken we gebruik van cryptografische hashing en goedgekeurde OT-methodieken zoals offline-to-online logic comparisons en native softwareverificatie.

Het Executive Stappenplan: De 5 Vragen en de 90-Dagen Roadmap

Cybersecurity en OT-weerbaarheid worden pas bestuurbaar wanneer het management de juiste vragen stelt. U hoeft als bestuurder geen specialist te zijn in industriële protocollen of PLC-logica, maar u moet wél de restrisico's kunnen beoordelen.

Stel uw IT- en OT-teams vandaag nog de volgende 5 cruciale vragen:

  1. Kritieke processen: Wat zijn onze vijf meest kritieke OT-processen en welke assets ondersteunen deze?
  2. Aantoonbaar herstel: Kunnen we deze specifieke processen aantoonbaar herstellen op basis van bewijs in plaats van aannames?
  3. Maximale uitvaltijd (RTO): Hoe snel moeten deze installaties minimaal weer veilig functioneren om schade te beperken?
  4. Onafhankelijkheid van de back-up: Is onze back-upomgeving zo geïsoleerd dat een cyberincident op de productievloer niet tegelijkertijd onze herstelmogelijkheden vernietigt?
  5. Eigenaarschap: Wie is de expliciete eigenaar van het herstelproces — niet alleen van de back-upjob, maar van het veilige herstarten van de operatie?

Het 90-Dagen Programma voor OT-Weerbaarheid

Om van aannames naar aantoonbare herstelbaarheid te komen, stelt u in drie fasen uw OT-continuïteit veilig:

Fase & Tijdsbestek

Kerndoel

Concreet Resultaat

Dag 1–30: Begrijpen

Weten wat werkelijk kritisch is voor de bedrijfsvoering.

Identificeer de belangrijkste operationele processen, koppel deze aan OT-assets, bepaal de maximale aanvaardbare uitvaltijd (RTO) en wijs per proces één duidelijke eigenaar aan.

Dag 31–60: Beschermen

Vaststellen of herstelbronnen betrouwbaar en geïsoleerd zijn.

Controleer of alle configuraties worden geback-upt, beoordeel de scheiding tussen productie en back-up, controleer toegangsrechten en elimineer single points of failure.

Dag 61–90: Bewijzen

Aantonen dat herstel in de praktijk werkt.

Voer een gecontroleerde restore-test uit voor de meest kritieke installatie, meet de werkelijke hersteltijd, leg tekortkomingen vast en stel een geborgd verbeterplan op.

Conclusie: Van vertrouwen naar bewijs

De kracht van een OT-back-up zit niet in het automatische proces van data kopiëren of het vullen van opslagcapaciteit. De werkelijke kracht zit in het aantoonbare vermogen om uw fysieke operatie na een ontregeling snel, veilig en voorspelbaar te hervatten.

Een volwassen organisatie accepteert dat technische storingen, menselijke fouten en cyberincidenten zullen plaatsvinden. Zij organiseert zich zo dat een incident niet kan uitgroeien tot een existentiële bedrijfscrisis.

"Als uw belangrijkste productieomgeving morgenochtend niet meer beschikbaar is: hoeveel van uw antwoorden zijn gebaseerd op bewijs — en hoeveel op vertrouwen?"

Neem de controle over uw operationele continuïteit

Wilt u niet langer afhankelijk zijn van aannames, maar exact weten waar uw organisatie staat? Information Systems Engineers (I.S.E.) helpt directies en operations teams bij het uitvoeren van onafhankelijke audits, het opzetten van gegarandeerde herstelstrategieën en het uitvoeren van effectieve hersteloefeningen.

Neem rechtstreeks contact met mij op voor een strategisch adviesgesprek en transformeer uw OT-back-up van een technische functie naar een aantoonbare bedrijfsgarantie.

Ricardo van Rhemen, Cybersecurity Specialist bij Information Systems Engineers (I.S.E.).

Download - Een effectieve back-upstrategie voor OT.pdf

OT Bedrijfscontinuïteit en Herstelstrategie
Watch the video

Waarom 99% van de OT-back-ups faalt als de fabriek echt stilvalt (en hoe u uw bedrijf wél beschermt)

De recente, ontregelende cyberincidenten op kritieke nutsbedrijven en energie-infrastructuur in de Verenigde Staten en het Verenigd Koninkrijk hebben de kwetsbaarheid van onze fysieke wereld pijnlijk blootgelegd. In mijn dagelijkse praktijk met directies, risicomanagers en asset owners zie ik een harde realiteit: onze industriële infrastructuur en fysieke ketens draaien op Operationele Technologie (OT), maar de herstelbaarheid daarvan wordt ernstig onderschat.

Veel bestuurders gaan er vanuit dat stilstand voornamelijk het gevolg is van geavanceerde cyberaanvallen zoals ransomware. De werkelijkheid is echter veel genuanceerder: een fysieke installatie — of het nu gaat om een fabriek, waterzuivering of energie-installatie — hoeft niet eens gehackt te worden om stil te vallen. Een defecte controller, een beschadigde configuratie, een mislukte firmware-update of een menselijke fout van een medewerker die een verkeerde configuratie terugzet, heeft exact hetzelfde effect: de operatie stopt.

Hier wreekt zich het fundamentele verschil tussen kantoor-IT en OT. Bij traditionele IT draait een back-up om het veiligstellen en herstellen van data. Bij Operationele Technologie gaat het om een heel andere, existentiële vraag: kan de organisatie haar fysieke proces veilig en voorspelbaar opnieuw laten functioneren wanneer de digitale besturing uitvalt? Een effectieve OT-back-upstrategie begint daarom niet bij software of opslagcapaciteit, maar bij de bedrijfsimpact van fysieke stilstand.

Inzicht 1: De gevaarlijkste back-up is degene waarvan iedereen denkt dat hij werkt

Een groen vinkje op een IT-dashboard garandeert op geen enkele wijze dat uw fabriek na een calamiteit weer kan opstarten.

In veel organisaties kijkt de directie naar maandelijkse rapportages waarin staat dat "99,8% van de back-upjobs succesvol is afgerond". Dit geeft een gevaarlijke schijn van veiligheid. In een OT-omgeving gaat het namelijk om veel meer dan alleen het kopiëren van bestanden of data.

Wanneer men uitsluitend vanuit een IT-dataperspectief naar back-ups kijkt, ontbreken de meest cruciale elementen die nodig zijn om een fysieke installatie weer tot leven te wekken:

  • PLC- en DCS-besturingsprogramma's
  • HMI- en SCADA-configuraties en grafische bestanden
  • Engineeringprojecten en broncode
  • Netwerkconfiguraties en firewallregels
  • Specifieke firmware- en softwareversies
  • Procesparameters, recepturen en setpoints
  • Historische procesdata (Historian-databases)
  • Certificaten, licenties en gebruikersconfiguraties
  • Essentiële documentatie van kritieke assets

Om te voorkomen dat onopgemerkte of ongeautoriseerde wijzigingen in deze configuraties tot mislukte herstelacties leiden, maken geavanceerde OT-omgevingen gebruik van industriële DevOps (Git-gebaseerd versiebeheer) en geautomatiseerde wijzigingsdetectie. Dit legt exact vast wie welke PLC-logica of HMI-instelling heeft aangepast vóórdat er een back-up wordt gemaakt.

"De gevaarlijkste back-up is degene waarvan iedereen denkt dat hij werkt."

Analyse door Ricardo: De blinde vlek voor het management

Voor een manager is dit de grootste blinde vlek in bedrijfscontinuïteit. Een back-up kan technisch gezien 100% geslaagd zijn, maar operationeel waardeloos blijken als blijkt dat een specifieke licentie ontbreekt, de softwareversie niet meer wordt ondersteund, of de back-up niet overeenkomt met de fysieke status van de installatie.

Beoordeel uw OT-back-upomgeving daarom nooit op opgeslagen back-upvolume, maar uitsluitend op aantoonbare herstelbaarheid. De centrale vraag op directieniveau mag niet zijn of er een back-up is gemaakt, maar of een kritieke installatie met die back-up gecontroleerd en veilig hersteld kan worden.

Inzicht 2: OT is geen kantoor-IT – Waarom standaard back-ups falen in de fabriek

In kantoor-IT kunnen servers of laptops relatief eenvoudig worden vervangen of geüpdatet. In de OT-wereld is de digitale besturing direct verbonden met de fysieke werkelijkheid en afhankelijk van complexe randvoorwaarden.

Herstel in OT valt of staat met de levenscyclus van industriële assets en een duidelijke herstelprioritering. Niet elke asset heeft immers dezelfde urgentie. Zo kent een volwassen OT-herstelstrategie een gelaagde opbouw waarbij Tier 0 (Veiligheid & Kernbesturing) de absolute hoogste prioriteit krijgt. Safety Instrumented Systems (SIS) en kritieke veiligheids-PLC's moeten gegarandeerd en gecontroleerd functioneren voordat de reguliere procesbesturing of HMI-laag (Tier 1) weer online gebracht mag worden.

Veel installaties draaien bovendien op verouderde (legacy) apparatuur die specifieke beperkingen kent, zoals een gebrek aan moderne beveiligingsfuncties of beperkte beschikbaarheid van vervangende hardware. Een succesvolle herstelactie vereist daarom meer dan alleen een digitaal bestand; er is een fysieke keten van afhankelijkheden nodig:

  • Fysieke wisselstukken (spare parts plan): Hardware die 100% compatibel is met de digitale back-ups om vertragingen in de toeleveringsketen op te vangen.
  • Gespecialiseerde apparatuur: Beschikbaarheid van specifieke engineeringsoftware, licenties en gespecialiseerde kabels ter plaatse.
  • "Golden Image" strategie: Een schone, vooraf gevalideerde "Golden Image" van het Engineering Workstation (EWS) — inclusief besturingssysteem, programmeersoftware en bekende goedwerkende besturingslogica — bewaard op een offline drager om herbesmetting bij herstel te voorkomen.
  • Aanvullende fysieke en digitale documentatie: Documenten in zowel geprinte als elektronische vorm, waaronder I/O-lijsten, schakelschema's, netwerkdiagrammen, apparatuurspecificaties, Safety Requirements Specifications (SRS), control narratives en Cause & Effect-matrices.

Cybersecurity en IT kunnen de randvoorwaarden en infrastructuur leveren, maar Operations bepaalt uiteindelijk wat een veilige, werkbare en gecontroleerde herstelactie is.

Info OT Back upstrategie

Inzicht 3: Bescherm de back-up alsof het uw meest kritieke asset is (De 3-2-1-1-0 Regel)

Bij moderne cyberincidenten (zoals ransomware-aanvallen) richt een aanvaller zich vaak niet direct op de productieomgeving. Het primaire doel is het uitschakelen of vernietigen van de back-ups en herstelmogelijkheden, zodat de organisatie geen uitweg meer heeft.

Een back-up die samen met de productieomgeving wordt vernietigd of versleuteld, biedt geen enkele continuïteit. Om dit te voorkomen, hanteren wij binnen OT de geavanceerde 3-2-1-1-0 Back-upregel:

  • 3 kopieën van de data en configuraties behouden.
  • 2 verschillende mediatypes gebruiken voor opslag.
  • 1 kopie op een offsite locatie bewaren.
  • 1 kopie bewaren die immutable (onveranderbaar/WORM-opslag) of air-gapped (fysiek losgekoppeld van het netwerk) is.
  • 0 fouten na automatische en periodieke herstelverificatie.


Analyse door Ricardo: De back-up als crisisinfrastructuur

De back-upomgeving is geen passief archief; het is een cruciaal onderdeel van uw crisisinfrastructuur. Dit betekent dat de back-upomgeving strikt gescheiden moet zijn van de productieomgeving. Zij mag niet afhankelijk zijn van dezelfde netwerkverbindingen, domeinen of gebruikersaccounts als het productienetwerk. Wie toegang heeft tot de productieomgeving, hoort niet automatisch autorisatie te hebben om back-ups te wijzigen of te verwijderen.

Inzicht 4: Testen zonder stilstand – Van aannames naar aantoonbare herstelbaarheid

Veel managers aarzelen om back-ups te testen uit angst voor productieverstoring of ongewenste stilstand. Dit leidt ertoe dat back-ups pas voor het eerst worden getest wanneer er een echt incident plaatsvindt — het slechtst denkbare moment.

Om te testen zonder risico voor de live productie, maken we gebruik van een Digital Twin (een virtuele sandbox-omgeving). Hierin kunnen herstelprocedures, patches en herstelketens veilig worden gevalideerd. Om stapsgewijs naar aantoonbare paraatheid toe te werken, hanteren we 5 herstelniveaus:

  1. Niveau 1: Bewijs van aanwezigheid — Kan het back-upbestand worden gevonden, geïndexeerd en geopend?
  2. Niveau 2: Technische restore — Kan het systeem of de configuratie succesvol worden teruggezet in een gecontroleerde testomgeving?
  3. Niveau 3: Functionele validatie — Gedraagt het herstelde systeem en de software zich inhoudelijk zoals verwacht?
  4. Niveau 4: Integrale hersteltest — Kunnen meerdere afhankelijke systemen (zoals PLC, HMI en SCADA) in samenhang worden hersteld?
  5. Niveau 5: Crisissimulatie — Kan het responsteam onder tijdsdruk en gesimuleerde crisissituaties de installatie herstellen?

Om te garanderen dat herstelde code en configuraties 100% zuiver zijn en niet zijn aangetast, maken we gebruik van cryptografische hashing en goedgekeurde OT-methodieken zoals offline-to-online logic comparisons en native softwareverificatie.

Het Executive Stappenplan: De 5 Vragen en de 90-Dagen Roadmap

Cybersecurity en OT-weerbaarheid worden pas bestuurbaar wanneer het management de juiste vragen stelt. U hoeft als bestuurder geen specialist te zijn in industriële protocollen of PLC-logica, maar u moet wél de restrisico's kunnen beoordelen.

Stel uw IT- en OT-teams vandaag nog de volgende 5 cruciale vragen:

  1. Kritieke processen: Wat zijn onze vijf meest kritieke OT-processen en welke assets ondersteunen deze?
  2. Aantoonbaar herstel: Kunnen we deze specifieke processen aantoonbaar herstellen op basis van bewijs in plaats van aannames?
  3. Maximale uitvaltijd (RTO): Hoe snel moeten deze installaties minimaal weer veilig functioneren om schade te beperken?
  4. Onafhankelijkheid van de back-up: Is onze back-upomgeving zo geïsoleerd dat een cyberincident op de productievloer niet tegelijkertijd onze herstelmogelijkheden vernietigt?
  5. Eigenaarschap: Wie is de expliciete eigenaar van het herstelproces — niet alleen van de back-upjob, maar van het veilige herstarten van de operatie?

Het 90-Dagen Programma voor OT-Weerbaarheid

Om van aannames naar aantoonbare herstelbaarheid te komen, stelt u in drie fasen uw OT-continuïteit veilig:

Fase & Tijdsbestek

Kerndoel

Concreet Resultaat

Dag 1–30: Begrijpen

Weten wat werkelijk kritisch is voor de bedrijfsvoering.

Identificeer de belangrijkste operationele processen, koppel deze aan OT-assets, bepaal de maximale aanvaardbare uitvaltijd (RTO) en wijs per proces één duidelijke eigenaar aan.

Dag 31–60: Beschermen

Vaststellen of herstelbronnen betrouwbaar en geïsoleerd zijn.

Controleer of alle configuraties worden geback-upt, beoordeel de scheiding tussen productie en back-up, controleer toegangsrechten en elimineer single points of failure.

Dag 61–90: Bewijzen

Aantonen dat herstel in de praktijk werkt.

Voer een gecontroleerde restore-test uit voor de meest kritieke installatie, meet de werkelijke hersteltijd, leg tekortkomingen vast en stel een geborgd verbeterplan op.

Conclusie: Van vertrouwen naar bewijs

De kracht van een OT-back-up zit niet in het automatische proces van data kopiëren of het vullen van opslagcapaciteit. De werkelijke kracht zit in het aantoonbare vermogen om uw fysieke operatie na een ontregeling snel, veilig en voorspelbaar te hervatten.

Een volwassen organisatie accepteert dat technische storingen, menselijke fouten en cyberincidenten zullen plaatsvinden. Zij organiseert zich zo dat een incident niet kan uitgroeien tot een existentiële bedrijfscrisis.

"Als uw belangrijkste productieomgeving morgenochtend niet meer beschikbaar is: hoeveel van uw antwoorden zijn gebaseerd op bewijs — en hoeveel op vertrouwen?"

Neem de controle over uw operationele continuïteit

Wilt u niet langer afhankelijk zijn van aannames, maar exact weten waar uw organisatie staat? Information Systems Engineers (I.S.E.) helpt directies en operations teams bij het uitvoeren van onafhankelijke audits, het opzetten van gegarandeerde herstelstrategieën en het uitvoeren van effectieve hersteloefeningen.

Neem rechtstreeks contact met mij op voor een strategisch adviesgesprek en transformeer uw OT-back-up van een technische functie naar een aantoonbare bedrijfsgarantie.

Ricardo van Rhemen, Cybersecurity Specialist bij Information Systems Engineers (I.S.E.).

Download - Een effectieve back-upstrategie voor OT.pdf

Security Nieuws

Back To Top